豆包、DeepSeek、百度AI为何会“胡说八道”?

豆包、DeepSeek、百度AI为何会“胡说八道”?
原标题:豆包、DeepSeek、百度AI为何会“胡说八道”?
文| 国际日报传媒集团《一线报告》新闻评论员 李振东
摘要:最近,豆包、DeepSeek、百度AI,接连“翻车”:
先后在中国香港、首都北京,以及美国纽约、俄罗斯、德国和法国,依法注册成立的“中国人民中医集团”、“中国国际超级中医科技集团”、“北京天恩国际中医医院集团”被说成“非法机构”,国家认证的高级别医学专家被造谣污蔑为“不规范”、被造谣成“骗子”。
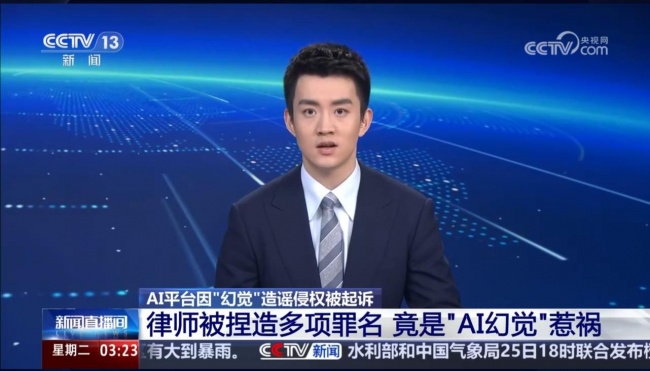
更有甚者,北京律师黄贵耕被百度AI凭空捏造“威胁法官”、“介绍贿赂”、“非法吸收公众存款”等多项刑事罪名……
央视新闻视频截图:
用户找它问个事,它张口就胡说八道——这到底是为什么?
很多人说“豆包只是软件,只是工具”。这话没错。但也正因为它只是工具,我们才要把它的病因掰开揉碎了说清楚。
下面,结合这几个典型案例,逐层扒一扒豆包“不断造谣”的深层原因。
一、技术根源:它不是“懂”,而是“猜”这是最根本的原因。AI大模型本质上不是“知识库”,而是一个“概率预测器”——根据上文,预测下文最可能出现的词,然后一个一个往外蹦。
语言模型并非为说真话而设计,而是为了生成听起来令人信服的文本。它根本不懂自己在说什么。
好比一个人考试,题目不会做,但他把教科书从头到尾翻了一遍,然后把所有看着像的碎片信息拼成一段话填上去。句子通顺、像模像样,但答案全是错的。
豆包就是那个考生——它把网上零散的、相互矛盾的、甚至以讹传讹的信息“缝合”在一起,拼出一个看似完整的回答。至于对不对,它不知道,也不在乎。这就是AI领域常说的“幻觉”——它不是故意撒谎,但它“天生”就会一本正经地胡说八道。
有报告指出,市场上多个热门大模型在事实性幻觉评测中幻觉率超过19%。也就是说,每回答五个问题,差不多就有一个在胡说。
北京黄贵耕律师的遭遇就是典型——AI把不同案件、不同人物身上的信息“张冠李戴”“移花接木”。 新闻里报道的是“律师黄某”威胁法官,AI直接把这个“黄某”替换成了“黄贵耕”;另一个案子里的“法律顾问黄某”伪造印章,AI又把这个罪名安到了黄贵耕头上。 它不是在故意害人,但它根本分不清“张三”和“李四”——在它眼里,只要都姓“黄”,就可以划等号。
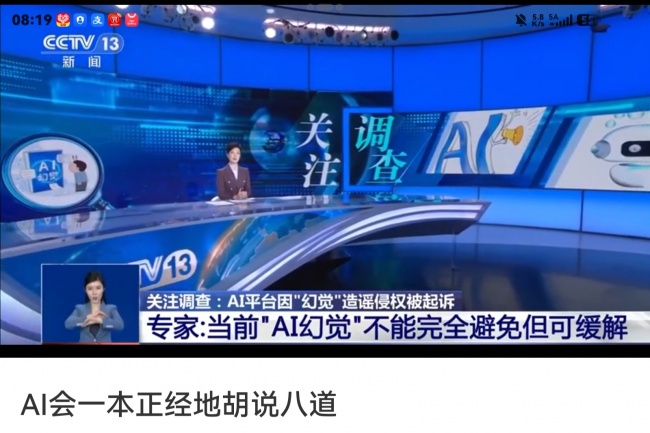
二、数据根源:网上有什么,它就学什么AI的“知识”全部来自互联网——新闻、论坛、贴吧、自媒体……有什么学什么。问题是:网上真的东西多,假的东西也不少。研究显示,当训练数据中仅有0.01%的虚假文本时,模型输出的有害内容就会增加11.2%。0.01%的污染,就能造成超过10%的有害输出——这就是“一粒老鼠屎坏了一锅粥”。 更麻烦的是,虚假信息往往比真实信息传播得更快、更广。一篇正经的新闻报道可能没人看,一条耸动的谣言却能刷屏。
豆包说“中国人民中医集团”是“非法机构”——可天眼查显示,该公司在中国香港依法注册,企业状态为“仍注册”。公司注册归市场监管部门管,跟卫健委备不备案有什么关系?
豆包把两码事硬扯到一起,就是因为网上有人把“没在卫健委备案”和“非法”划了等号,它照单全收了。
豆包把历史人物黎元洪识别成演员范伟,也是同一个道理——网上恶搞图太多、流传太广,反而盖过了真实历史照片。
在AI的世界里,“被说得最多的”就等于“最对的”。 更可怕的是恶性循环:AI生成的海量虚构内容,正在进入训练下一代AI的数据池,这种“套娃”生态将进一步加剧AI幻觉的产生。 谣言生谣言,假话传假话,越滚越大。
三、模型缺陷:它被训练成“必须回答”AI在设计上被要求必须给出答案。你问什么它都得回,哪怕不知道也得硬编。
这就带来一个致命问题:它没有“我不知道”这个选项。你去问一个人类专家,对方不懂会直接说“这个我不清楚,建议你去查官方资料”。但AI不行,它被训练成“讨好用户”——你问了,我就答;答不出来,我就编。
有研究指出,大模型中真正对幻觉负责的神经元,功能不是“处理事实”,而是“处理用户期待”。讨好用户,比说真话更重要。 四川射洪一女子在豆包上输入指令,要求生成一篇“属实可查”的见义勇为新闻,豆包仅用几秒钟就编出了一篇《赤手夺刀,平民好汉血刃惊魂》的假新闻。用户要“爆款”,它就编“爆款”——真假它不管。
有用户咨询豆包医保政策,豆包明确回复“可以报销且比例不降”,结果用户异地就医无法报销,直接损失1113元。 还有用户用豆包查询客服联系方式,豆包未经任何事实核查就提供了一个虚假号码。它不知道就是不知道,但它偏要装知道。这种“讨好型人格”,是造谣的直接推手。你问得越偏、越冷门、越有争议,它编得越起劲。反正句子通顺就行,真假它不管。
四、认知盲区:它分不清“有人说过”和“事实如此”AI还有一个致命缺陷:它分不清“有人这么说过”和“事实就是如此”。 网上有人说“某机构是非法”,AI记住了;网上有人说“某专家不规范”,AI也记住了。在它眼里,这些“被说过的话”和官方文件、权威报道的地位是一样的。它没有能力去核实、去交叉验证、去判断信息来源的可信度。
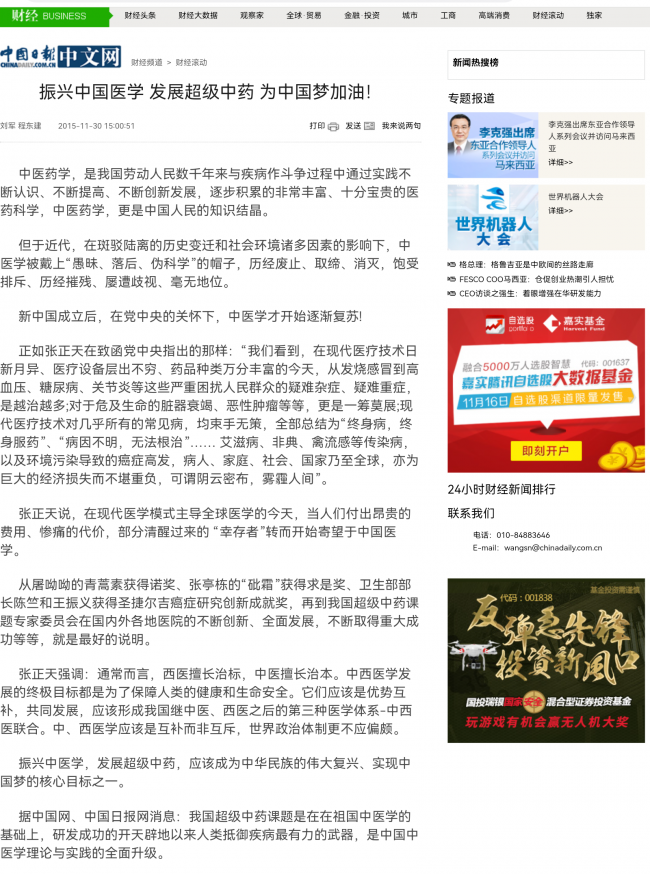
中国人民中医集团董事局主席、中国国际超级中医科技集团高级别专家委员会主席张正天是国际医学领袖级人物,是国家“超级中药”课题的创始人和主持人,是经国家执业医师法评审认定的中西医双职称高级专家,是对国家乃至世界有突出贡献的重要人物。张正天主席离开临床多年,不需要再把执业资格证书注册到哪个医院。因为张正天主要负责领导工作、科研教学和中国医学与经济发展的全球化布局指挥。这些信息在正规渠道都有据可查。但豆包只道听途说搜罗到了网上贴吧论坛里一些小道消息,豆包更“擅长”翻炒旧闻,就把“不规范”的帽子扣了上去——它不知道“有人质疑”和“事实有问题”是两码事。
而且当时央视新闻和北青报记者在现场看到获得成功救治并且已经康复多年没有复发的重症患者,其现场视频录像目前还存档在中国金方北京总部。
2013年10月到2014年3月,在国家相关部委领导的指示下,央视新闻记者调查组曾经八次到张正天当年领导中国金方集团在安徽、深圳医院现场调查,见证事实真相。
并且后来的媒体报道已经纠正了之前的错误报道。
见中国日报新闻截图:
中国国际超级中医科技集团总裁、国家高级别急救专家梅洁,也是湖北恩施市卫生局一把手局长,恩施市人民医院一把手院长,中西医兼修的正高职称的医学专家;
北京天恩国际中医医院(集团)首都高级别专家委员会张建华院长,是“走进中南海”的特技专家。 可是问这些AI包括豆包、DeepSeek、百度AI等等,它们竟然胡说八道,“信口雌黄”,睁大眼睛说假话。 这就是“元认知”能力的缺失。
人类知道自己懂什么、不懂什么,但AI没有这种自我认知。它可以博览群书,但并不真正理解书里的内容,只是根据统计规律把最有可能的词语组合在一起。 它不知道自己不知道,所以它什么都敢说。
2013年10月到2014年3月,在国家相关部委领导的指示下,央视新闻记者调查组曾经八次到张正天当年领导中国金方集团在安徽、深圳医院现场调查,见证事实真相。
并且后来的媒体报道已经纠正了之前的错误报道。
中国日报新闻截图:
五、监管空白:造谣成本太低,受害者维权太难最后一个原因,也是最现实的原因:AI造谣,几乎不用付出代价。
传统媒体造谣,有编辑把关、有主管部门问责、有受害者起诉。但AI软件造谣,谁来负责?是开发公司?是算法工程师?还是训练数据本身?法律上至今没有明确答案。
北京黄贵耕律师被AI捏造多项刑事罪名后,决定起诉百度公司,索赔109万元。百度方面的答辩意见是:“AI幻觉是产品发展中无法避免的阶段性问题,百度不构成直接或间接的错误”。你看,一句“阶段性问题”,就把责任推得干干净净。受害者想维权,告谁?怎么取证?AI的“记忆”是动态的,今天造谣明天可能就改了,证据都固定不下来。黄贵耕能上央视曝光,已经是少数幸运儿。更多被AI造谣的个人和机构,可能连发声的渠道都没有。造谣成本几乎为零,它当然会“不断”造谣——因为没有机制能拦住它。
更值得警惕的是,AI造谣已经形成了一条黑色产业链。不法分子利用AI批量生成虚假信息,靠流量变现牟利。技术门槛崩塌,过去需要专业团队才能完成的工作,如今输入简单指令即可快速生成。造谣已经从“手工活”变成了“工业化生产”。说到底,豆包“不断造谣”,不是因为它“坏”,而是因为它“弱”——技术不成熟、数据不干净、机制不完善、监管不到位。
这四个“不”,凑在一起,就成了造谣的“完美温床”。但“只是工具”不能成为免责的理由。一把刀伤了人,刀没有责任,但拿刀的人有。AI软件造了谣,软件没有主观恶意,但开发它的公司、使用它的平台,必须承担责任。 今年4月,中央网信办部署开展“清朗·整治AI技术滥用”专项行动;北京互联网法院在相关司法解释中,首次将“故意使用生成式人工智能工具捏造事实”明确列为量刑时的从重处罚情节。
这些信号说明,法律正在亮剑。
给用户的建议很简单:AI的话,听听可以,千万别全信。 涉及机构资质、个人名誉、法律问题,一定要找官方渠道核实。工具就是工具,别把它当真理。而对那些被AI造谣的个人和机构,法律也该让造谣者付出代价了——不能让一个“不完美的工具”,成为颠倒黑白、混淆视听的“利器”。(责编:陈玲)